Song Y, Li Z, Zhang X, Fang S, Zhang Q, Li X.
J Gastroenterol Hepatol. 2026 Aug 24. doi: 10.1111/jgh.70694.
LETTER TO THE EDITOR
편집자님께,
저희는 최근 발표한 다기관 연구에서 단일 내시경 영상을 이용하여 자가면역성 위염(autoimmune gastritis, AIG)과 Helicobacter pylori 연관 위축성 위염(H. pylori–associated atrophic gastritis, HpAG)을 감별하는 모델인 CorpusNet-AIG를 개발한 바 있습니다[1]. 이번에는 동일한 검증 코호트를 이용하여 ChatGPT-4o의 진단 성능을 사후 분석으로 평가하였습니다. 기존 연구에서 CorpusNet-AIG는 전문가 수준의 진단 성능을 보였지만[1], 범용 다중모달 대규모 언어모델(multimodal large language model, MLLM)이 이처럼 세밀한 감별 진단을 수행할 수 있는지는 알려져 있지 않았습니다.
AIG와 HpAG는 원인, 임상적 관리 방법 및 추적관찰의 필요성에서 상당한 차이가 있음에도 불구하고, 두 질환 모두 점막 창백, 혈관 투시상 증가 및 위주름 소실과 같은 소견을 공유하기 때문에 내시경적으로 감별하기가 여전히 어렵습니다[2]. 저희는 이전 연구에서 사용한 것과 동일한 검증 코호트를 대상으로 ChatGPT 웹 인터페이스를 통해 ChatGPT-4o의 성능을 CorpusNet-AIG와 비교하였습니다. 평가 당시 OpenAI의 ChatGPT 모델 선택 메뉴에서 GPT-4o를 선택하였으며, 접속 및 평가는 2025년 7월부터 8월까지 이루어졌습니다. 검증 자료는 두 기관에서 수집된 273개의 내부 검증 영상(AIG 133개, HpAG 140개)과 서로 독립적인 세 기관에서 수집된 765개의 외부 검증 영상(AIG 396개, HpAG 369개)으로 구성되었습니다. 새로운 자료는 추가로 수집하지 않았으며, 모든 영상은 업로드 전에 개인 식별정보가 완전히 제거되었습니다.
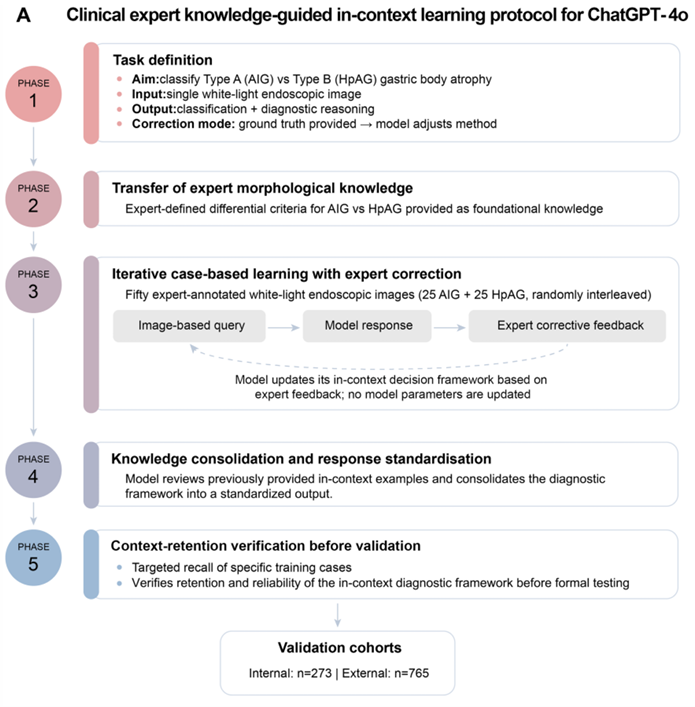
ChatGPT-4o는 하나의 대화 세션 안에서 모델의 매개변수를 업데이트하지 않은 채 AIG와 HpAG의 영상 특징을 단계적으로 익히도록 설계된, 전문가 지식 기반의 5단계 문맥 내 학습(in-context learning) 프로토콜을 통해 평가하였습니다. 이 프로토콜에서는 먼저 A형(Type A)과 B형(Type B)의 분류 체계를 정의하고, 형태학적 진단 기준을 모델에 전달하였습니다. 이어서 전문가가 진단한 50개의 영상을 이용하여 반복적으로 피드백을 제공하고, 출력 형식을 표준화한 후, 마지막으로 모델이 앞서 제공된 문맥을 유지하고 있는지 확인하였습니다.
학습 예시로 사용한 50개의 영상은 기존 CorpusNet-AIG 학습 데이터셋에서 무작위로 추출하였으며, AIG 영상 25개와 HpAG 영상 25개로 구성되었습니다. 이 영상들은 환자 단위에서 두 검증 코호트와 완전히 독립적이었습니다. 이후 각 검증 영상을 한 번에 하나씩 개별적으로 입력하고, 고정된 프롬프트를 사용하여 A형 또는 B형으로 분류하도록 요청하였습니다. 또한 0%에서 100% 사이의 신뢰도 점수, 구조화된 설명 및 영상 품질에 대한 의견도 함께 제시하도록 하였습니다.
검증 과정에서는 정답 라벨을 제공하지 않았으며, 진단 결과에 대한 수정 피드백이나 추가 학습 예시도 제시하지 않았습니다. 문맥 내 학습 상태를 유지하기 위해 모든 평가는 하나의 대화 세션에서 완료하였습니다. 이번 평가와 CorpusNet-AIG와의 직접적인 일대일 성능 비교는 기존 연구 보고에는 포함되지 않았던 내용입니다. 두 모델의 진단 정확도는 McNemar 검정을 이용하여 비교하였습니다.
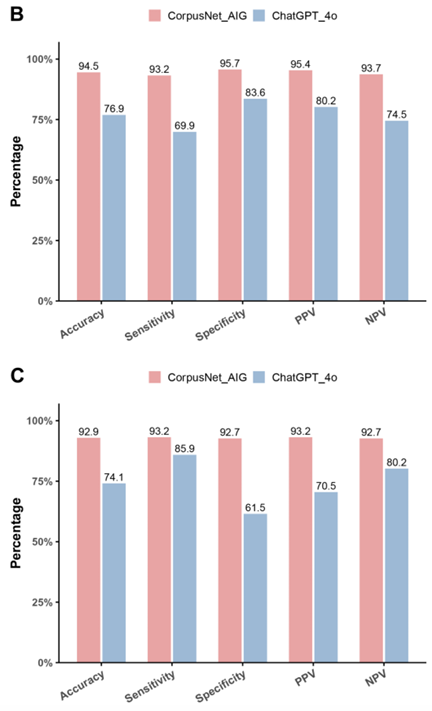
CorpusNet-AIG는 내부 검증 코호트(94.51% 대 76.9%)와 외부 검증 코호트(92.94% 대 74.1%) 모두에서 ChatGPT-4o보다 유의하게 우수한 성능을 보였습니다(모두 p<0.001; Figure 1).
FIGURE 1. Head-to-head evaluation of CorpusNet-AIG and ChatGPT-4o for endoscopic differentiation of autoimmune gastritis from Helicobacter pylori–associated atrophic gastritis.
(A) Five-phase clinical expert knowledge-driven in-context learning protocol for ChatGPT- 4o: (1) task definition and iterative learning paradigm specification; (2) foundational knowledge transfer of expert- derived morphological criteria for AIG and HpAG; (3) it erative case- based in- context learning with 50 expert- annotated white- light endoscopic images randomly sampled from the original CorpusNet- AIG training dataset (25 AIG and 25 HpAG), with no patient- level overlap with either validation cohort, with corrective feedback; (4) knowledge consoli dation with role assignment as an experienced endoscopist and standardized output formatting; and (5) spot- check context- retention verification. No model parameters were updated during this process.
전체 1,038개 영상을 대상으로 하였을 때 ChatGPT-4o의 정확도는 74.9%(95% 신뢰구간, 72.1%–77.5%), 민감도는 81.9%, 특이도는 67.6%였습니다.
FIGURE 1. (B,C) Comparative diagnostic performance on the internal validation dataset (B; n = 273) and external validation dataset (C; n = 765), showing accuracy, sensitivity, specificity, PPV, and NPV. CorpusNet- AIG (red) consistently outperformed ChatGPT- 4o (blue) across all metrics.
이번 평가에서 ChatGPT-4o에는 해당 과제에 특화된 50개의 문맥 내 학습 예시가 제공된 반면, CorpusNet-AIG는 해당 과제에 특화된 1,099개의 영상을 이용하여 학습되었습니다. 따라서 이 비교는 해당 과제에 특화된 지도학습의 차이만을 대상으로 하며, GPT-4o가 사전학습에 사용한 데이터는 고려하지 않았습니다.
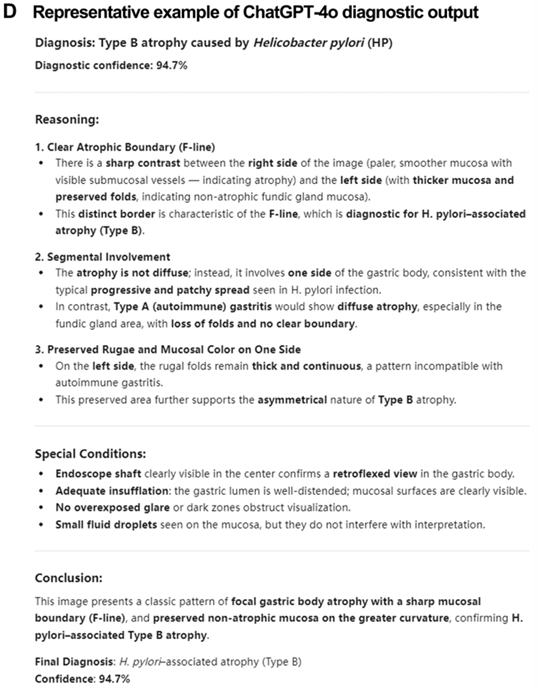
ChatGPT-4o는 위축의 분포, 경계부의 특징, 잔존하는 위저선 형태, 동반된 점막 소견 및 영상 품질의 한계 등을 기술하는 구조화된 결과도 생성하였습니다(Figure 1D). 이는 CorpusNet-AIG에서는 제공되지 않는 기능입니다.
FIGURE 1. (D) Representative case of H. pylori–associated gastric corpus atrophy (Type B), showing the white-light endoscopic image and the structured explanatory output generated by ChatGPT-4o, including diagnostic classification, confidence score, morphology-based observations, and image-quality remarks.
두 모델 간의 정확도 차이는 모델의 구조와 최적화 방식이 근본적으로 다르기 때문으로 보입니다. CorpusNet-AIG는 대규모 라벨링 데이터셋을 이용한 경사도 기반 최적화 과정을 통해 AIG와 HpAG 사이의 미세한 질감 및 색조 차이를 정교하게 구분하도록 조정된, 해당 과제에 특화된 시각적 표현을 학습합니다[1]. 반면 ChatGPT-4o는 범용 다중모달 모델로서 이 특정 감별 과제를 위해 별도로 미세조정되지 않았습니다.
ChatGPT-4o가 생성한 설명은 모델이 실제로 충실하고 인과적인 추론을 수행했다는 직접적인 증거로 해석해서는 안 됩니다. 그러나 이러한 설명은 임상의가 진단 결과를 검토하고, 영상에서 관찰되는 소견을 체계적으로 정리하며, 영상 품질과 관련된 문제를 파악하고, 표준화된 보고서를 작성하는 데 도움을 줄 수 있습니다. 따라서 이 두 가지 모델의 접근 방식은 서로 경쟁한다기보다 상호보완적인 강점을 지닌다고 볼 수 있습니다.
대규모 언어모델이 소화기학 분야에서 점차 임상적 유용성을 보여주고 있는 상황에서, 전문화된 딥러닝 모델의 고정밀 분류 능력과 다중모달 대규모 언어모델이 생성하는 구조화된 설명을 결합한 하이브리드 시스템은 해석 가능성이 더욱 높은 인공지능 보조 내시경 진료 체계를 구축할 수 있습니다. 최근 다중모달 대규모 언어모델을 활용한 내시경 보고서 작성 연구에서도 이러한 하이브리드 구조의 실현 가능성이 뒷받침되고 있습니다[3].
이번 연구에는 몇 가지 한계가 있습니다. 단 하나의 다중모달 대규모 언어모델만을 평가하였으며, ChatGPT 웹 인터페이스를 사용했기 때문에 평가에 사용된 모델 버전을 특정 시점의 동일한 상태로 고정하거나 사용자가 디코딩 매개변수를 직접 설정할 수 없었습니다. 따라서 이번 결과를 정확하게 재현하는 데에는 한계가 있을 수 있으며, 모델 업데이트나 대화 세션에 따라 성능이 달라질 가능성이 있습니다. 또한 이번 평가는 선별된 고품질 백색광 정지 영상을 기반으로 수행되었으며, 실시간 내시경 검사에서의 성능은 평가하지 않았습니다. 모든 영상은 업로드 전에 개인 식별정보가 완전히 제거되었지만, 향후 전향적 연구에서는 결과의 재현성, 신뢰도 점수의 보정, 실시간 진단 성능 및 하이브리드 시스템이 전문화된 영상 분류기 단독 사용보다 실제 임상적 의사결정을 향상시킬 수 있는지를 평가해야 합니다.
결론적으로, 이전 연구에서 보고한 코호트를 이용한 이번 사후 분석에서 ChatGPT-4o는 단일 영상을 바탕으로 AIG와 HpAG를 감별하는 데 있어 CorpusNet-AIG와 대등한 수준의 진단 정확도를 달성하지 못했습니다. 그러나 제한된 수의 과제 특이적 문맥 내 학습 예시만을 사용했다는 점과 구조화된 결과를 생성할 수 있다는 점을 고려하면, ChatGPT-4o를 인공지능 보조 내시경 시스템의 보완적 구성 요소로 활용할 가능성에 대해서는 추가 연구가 필요합니다.
References
1. Y. Song, X. Zhang, L. Shi, et al., “Artificial Intelligence for Single-Image Diagnosis of Autoimmune Gastritis Using Gastric Corpus Atrophy Images: A Multicenter Retrospective Diagnostic Study,” Journal of Gastroenterology and Hepatology 41 (2026): 1292–1302.
2. S. C. Shah, M. B. Piazuelo, E. J. Kuipers, and D. Li, “AGA Clinical Practice Update on the Diagnosis and Management of Atrophic Gastritis: Expert Review,” Gastroenterology 161 (2021): 1325–1332.e7.
3. R. Jiang, B. Chen, Z. Dong, et al., “Domain Specific Multimodal Large Language Model for Automated Endoscopy Reporting With Multicenter Prospective Validation,” npj Digital Medicine 9 (2026): 394.


Song Y, Li Z, Zhang X, Fang S, Zhang Q, Li X.
J Gastroenterol Hepatol. 2026 Aug 24. doi: 10.1111/jgh.70694.
LETTER TO THE EDITOR
편집자님께,
저희는 최근 발표한 다기관 연구에서 단일 내시경 영상을 이용하여 자가면역성 위염(autoimmune gastritis, AIG)과 Helicobacter pylori 연관 위축성 위염(H. pylori–associated atrophic gastritis, HpAG)을 감별하는 모델인 CorpusNet-AIG를 개발한 바 있습니다[1]. 이번에는 동일한 검증 코호트를 이용하여 ChatGPT-4o의 진단 성능을 사후 분석으로 평가하였습니다. 기존 연구에서 CorpusNet-AIG는 전문가 수준의 진단 성능을 보였지만[1], 범용 다중모달 대규모 언어모델(multimodal large language model, MLLM)이 이처럼 세밀한 감별 진단을 수행할 수 있는지는 알려져 있지 않았습니다.
AIG와 HpAG는 원인, 임상적 관리 방법 및 추적관찰의 필요성에서 상당한 차이가 있음에도 불구하고, 두 질환 모두 점막 창백, 혈관 투시상 증가 및 위주름 소실과 같은 소견을 공유하기 때문에 내시경적으로 감별하기가 여전히 어렵습니다[2]. 저희는 이전 연구에서 사용한 것과 동일한 검증 코호트를 대상으로 ChatGPT 웹 인터페이스를 통해 ChatGPT-4o의 성능을 CorpusNet-AIG와 비교하였습니다. 평가 당시 OpenAI의 ChatGPT 모델 선택 메뉴에서 GPT-4o를 선택하였으며, 접속 및 평가는 2025년 7월부터 8월까지 이루어졌습니다. 검증 자료는 두 기관에서 수집된 273개의 내부 검증 영상(AIG 133개, HpAG 140개)과 서로 독립적인 세 기관에서 수집된 765개의 외부 검증 영상(AIG 396개, HpAG 369개)으로 구성되었습니다. 새로운 자료는 추가로 수집하지 않았으며, 모든 영상은 업로드 전에 개인 식별정보가 완전히 제거되었습니다.
ChatGPT-4o는 하나의 대화 세션 안에서 모델의 매개변수를 업데이트하지 않은 채 AIG와 HpAG의 영상 특징을 단계적으로 익히도록 설계된, 전문가 지식 기반의 5단계 문맥 내 학습(in-context learning) 프로토콜을 통해 평가하였습니다. 이 프로토콜에서는 먼저 A형(Type A)과 B형(Type B)의 분류 체계를 정의하고, 형태학적 진단 기준을 모델에 전달하였습니다. 이어서 전문가가 진단한 50개의 영상을 이용하여 반복적으로 피드백을 제공하고, 출력 형식을 표준화한 후, 마지막으로 모델이 앞서 제공된 문맥을 유지하고 있는지 확인하였습니다.
학습 예시로 사용한 50개의 영상은 기존 CorpusNet-AIG 학습 데이터셋에서 무작위로 추출하였으며, AIG 영상 25개와 HpAG 영상 25개로 구성되었습니다. 이 영상들은 환자 단위에서 두 검증 코호트와 완전히 독립적이었습니다. 이후 각 검증 영상을 한 번에 하나씩 개별적으로 입력하고, 고정된 프롬프트를 사용하여 A형 또는 B형으로 분류하도록 요청하였습니다. 또한 0%에서 100% 사이의 신뢰도 점수, 구조화된 설명 및 영상 품질에 대한 의견도 함께 제시하도록 하였습니다.
검증 과정에서는 정답 라벨을 제공하지 않았으며, 진단 결과에 대한 수정 피드백이나 추가 학습 예시도 제시하지 않았습니다. 문맥 내 학습 상태를 유지하기 위해 모든 평가는 하나의 대화 세션에서 완료하였습니다. 이번 평가와 CorpusNet-AIG와의 직접적인 일대일 성능 비교는 기존 연구 보고에는 포함되지 않았던 내용입니다. 두 모델의 진단 정확도는 McNemar 검정을 이용하여 비교하였습니다.
CorpusNet-AIG는 내부 검증 코호트(94.51% 대 76.9%)와 외부 검증 코호트(92.94% 대 74.1%) 모두에서 ChatGPT-4o보다 유의하게 우수한 성능을 보였습니다(모두 p<0.001; Figure 1).
FIGURE 1. Head-to-head evaluation of CorpusNet-AIG and ChatGPT-4o for endoscopic differentiation of autoimmune gastritis from Helicobacter pylori–associated atrophic gastritis.
(A) Five-phase clinical expert knowledge-driven in-context learning protocol for ChatGPT- 4o: (1) task definition and iterative learning paradigm specification; (2) foundational knowledge transfer of expert- derived morphological criteria for AIG and HpAG; (3) it erative case- based in- context learning with 50 expert- annotated white- light endoscopic images randomly sampled from the original CorpusNet- AIG training dataset (25 AIG and 25 HpAG), with no patient- level overlap with either validation cohort, with corrective feedback; (4) knowledge consoli dation with role assignment as an experienced endoscopist and standardized output formatting; and (5) spot- check context- retention verification. No model parameters were updated during this process.
전체 1,038개 영상을 대상으로 하였을 때 ChatGPT-4o의 정확도는 74.9%(95% 신뢰구간, 72.1%–77.5%), 민감도는 81.9%, 특이도는 67.6%였습니다.
FIGURE 1. (B,C) Comparative diagnostic performance on the internal validation dataset (B; n = 273) and external validation dataset (C; n = 765), showing accuracy, sensitivity, specificity, PPV, and NPV. CorpusNet- AIG (red) consistently outperformed ChatGPT- 4o (blue) across all metrics.
이번 평가에서 ChatGPT-4o에는 해당 과제에 특화된 50개의 문맥 내 학습 예시가 제공된 반면, CorpusNet-AIG는 해당 과제에 특화된 1,099개의 영상을 이용하여 학습되었습니다. 따라서 이 비교는 해당 과제에 특화된 지도학습의 차이만을 대상으로 하며, GPT-4o가 사전학습에 사용한 데이터는 고려하지 않았습니다.
ChatGPT-4o는 위축의 분포, 경계부의 특징, 잔존하는 위저선 형태, 동반된 점막 소견 및 영상 품질의 한계 등을 기술하는 구조화된 결과도 생성하였습니다(Figure 1D). 이는 CorpusNet-AIG에서는 제공되지 않는 기능입니다.
FIGURE 1. (D) Representative case of H. pylori–associated gastric corpus atrophy (Type B), showing the white-light endoscopic image and the structured explanatory output generated by ChatGPT-4o, including diagnostic classification, confidence score, morphology-based observations, and image-quality remarks.
두 모델 간의 정확도 차이는 모델의 구조와 최적화 방식이 근본적으로 다르기 때문으로 보입니다. CorpusNet-AIG는 대규모 라벨링 데이터셋을 이용한 경사도 기반 최적화 과정을 통해 AIG와 HpAG 사이의 미세한 질감 및 색조 차이를 정교하게 구분하도록 조정된, 해당 과제에 특화된 시각적 표현을 학습합니다[1]. 반면 ChatGPT-4o는 범용 다중모달 모델로서 이 특정 감별 과제를 위해 별도로 미세조정되지 않았습니다.
ChatGPT-4o가 생성한 설명은 모델이 실제로 충실하고 인과적인 추론을 수행했다는 직접적인 증거로 해석해서는 안 됩니다. 그러나 이러한 설명은 임상의가 진단 결과를 검토하고, 영상에서 관찰되는 소견을 체계적으로 정리하며, 영상 품질과 관련된 문제를 파악하고, 표준화된 보고서를 작성하는 데 도움을 줄 수 있습니다. 따라서 이 두 가지 모델의 접근 방식은 서로 경쟁한다기보다 상호보완적인 강점을 지닌다고 볼 수 있습니다.
대규모 언어모델이 소화기학 분야에서 점차 임상적 유용성을 보여주고 있는 상황에서, 전문화된 딥러닝 모델의 고정밀 분류 능력과 다중모달 대규모 언어모델이 생성하는 구조화된 설명을 결합한 하이브리드 시스템은 해석 가능성이 더욱 높은 인공지능 보조 내시경 진료 체계를 구축할 수 있습니다. 최근 다중모달 대규모 언어모델을 활용한 내시경 보고서 작성 연구에서도 이러한 하이브리드 구조의 실현 가능성이 뒷받침되고 있습니다[3].
이번 연구에는 몇 가지 한계가 있습니다. 단 하나의 다중모달 대규모 언어모델만을 평가하였으며, ChatGPT 웹 인터페이스를 사용했기 때문에 평가에 사용된 모델 버전을 특정 시점의 동일한 상태로 고정하거나 사용자가 디코딩 매개변수를 직접 설정할 수 없었습니다. 따라서 이번 결과를 정확하게 재현하는 데에는 한계가 있을 수 있으며, 모델 업데이트나 대화 세션에 따라 성능이 달라질 가능성이 있습니다. 또한 이번 평가는 선별된 고품질 백색광 정지 영상을 기반으로 수행되었으며, 실시간 내시경 검사에서의 성능은 평가하지 않았습니다. 모든 영상은 업로드 전에 개인 식별정보가 완전히 제거되었지만, 향후 전향적 연구에서는 결과의 재현성, 신뢰도 점수의 보정, 실시간 진단 성능 및 하이브리드 시스템이 전문화된 영상 분류기 단독 사용보다 실제 임상적 의사결정을 향상시킬 수 있는지를 평가해야 합니다.
결론적으로, 이전 연구에서 보고한 코호트를 이용한 이번 사후 분석에서 ChatGPT-4o는 단일 영상을 바탕으로 AIG와 HpAG를 감별하는 데 있어 CorpusNet-AIG와 대등한 수준의 진단 정확도를 달성하지 못했습니다. 그러나 제한된 수의 과제 특이적 문맥 내 학습 예시만을 사용했다는 점과 구조화된 결과를 생성할 수 있다는 점을 고려하면, ChatGPT-4o를 인공지능 보조 내시경 시스템의 보완적 구성 요소로 활용할 가능성에 대해서는 추가 연구가 필요합니다.
References
1. Y. Song, X. Zhang, L. Shi, et al., “Artificial Intelligence for Single-Image Diagnosis of Autoimmune Gastritis Using Gastric Corpus Atrophy Images: A Multicenter Retrospective Diagnostic Study,” Journal of Gastroenterology and Hepatology 41 (2026): 1292–1302.
2. S. C. Shah, M. B. Piazuelo, E. J. Kuipers, and D. Li, “AGA Clinical Practice Update on the Diagnosis and Management of Atrophic Gastritis: Expert Review,” Gastroenterology 161 (2021): 1325–1332.e7.
3. R. Jiang, B. Chen, Z. Dong, et al., “Domain Specific Multimodal Large Language Model for Automated Endoscopy Reporting With Multicenter Prospective Validation,” npj Digital Medicine 9 (2026): 394.